Логи сервера — это последовательность записей о запросах, событиях и ошибках приложения. Они помогают увидеть, что произошло до сбоя, какой сервис его зафиксировал и повторяется ли проблема. Без временной шкалы диагностика превращается в догадки: разработчик смотрит только на последний экран и не замечает первопричину.
Перед чтением журнала определите контекст: какой сервис сломался, в какой момент, для какого URL или пользователя и что изменилось перед инцидентом. Не копируйте в отчёт токены, пароли, cookies и персональные данные. В логах должна оставаться техническая информация, достаточная для анализа, но безопасная для передачи команде.
Где искать серверные логи
Место зависит от инфраструктуры. На виртуальной машине записи могут лежать в системных каталогах журналов, рядом с веб-сервером или приложением. В контейнере их часто выводят в стандартный поток, а в облаке собирают в централизованную систему наблюдаемости. Уточните у команды, какой источник считается главным: локальный файл может быть неполным после перезапуска.
Сначала найдите самую свежую запись и проверьте часовой пояс. Несовпадение времени между сервером, базой и браузером создаёт ложную последовательность событий. Зафиксируйте идентификатор инстанса, имя сервиса и период, за который собирались данные. Это особенно важно при нескольких копиях приложения за балансировщиком.

Разберите структуру одной строки
Типичная запись содержит дату и время, уровень, имя компонента, сообщение и дополнительные поля. В структурированном JSON могут быть request_id, route, status_code, duration_ms и stack trace. В текстовом формате те же данные разделены пробелами или скобками. Научитесь читать одну строку полностью, прежде чем искать совпадения по одному слову.
| Поле | Зачем нужно | Вопрос при анализе |
|---|---|---|
| Timestamp | Выстроить последовательность | В одном ли часовом поясе время? |
| Level | Оценить важность | Это debug, warning, error или fatal? |
| Service | Найти источник | Какой компонент отвечает за сбой? |
| Request ID | Связать события | Какие записи относятся к одному запросу? |
| Status и duration | Понять результат и задержку | Ошибка единичная или массовая? |
Что означают уровни сообщений
Названия уровней различаются, но логика похожа. Debug нужен для подробной разработки, info описывает штатные события, warning предупреждает о потенциальной проблеме, error сообщает о неудачной операции, а critical или fatal указывает на ситуацию, способную остановить сервис. Не делайте вывод только по слову error: иногда приложение пишет его для обработанного исключения.
Сначала смотрите ошибки и предупреждения в узком временном окне, затем сопоставляйте их с информационными событиями. Если включить самый подробный режим на продакшене без ограничений, журнал быстро разрастётся и начнёт скрывать важные строки. Уровень логирования меняют по процедуре команды и возвращают к штатному значению после диагностики.
Фильтруйте по времени и идентификатору
Выберите период от нескольких минут до события и после него. Слишком широкий диапазон даёт тысячи нерелевантных записей, слишком узкий обрезает причину. Начните с времени, которое видит пользователь, добавьте запас до и после, затем сужайте окно по мере понимания последовательности.
Если в системе есть request_id или trace_id, используйте его в первую очередь. Идентификатор связывает входящий запрос, вызов базы, очередь и ответ. При отсутствии такого поля сопоставляйте timestamp, URL, код ответа и уникальный фрагмент сообщения, но отмечайте, что связь приблизительная.
- Найдите первую запись о симптоме.
- Поднимитесь на несколько строк выше и проверьте предупреждения.
- Свяжите события по идентификатору запроса или корреляции.
- Сравните длительность и статус успешного и ошибочного запроса.
- Проверьте соседние сервисы и внешние зависимости.
- Зафиксируйте гипотезу и проверку, которая её подтверждает или опровергает.
Как отличить симптом от причины
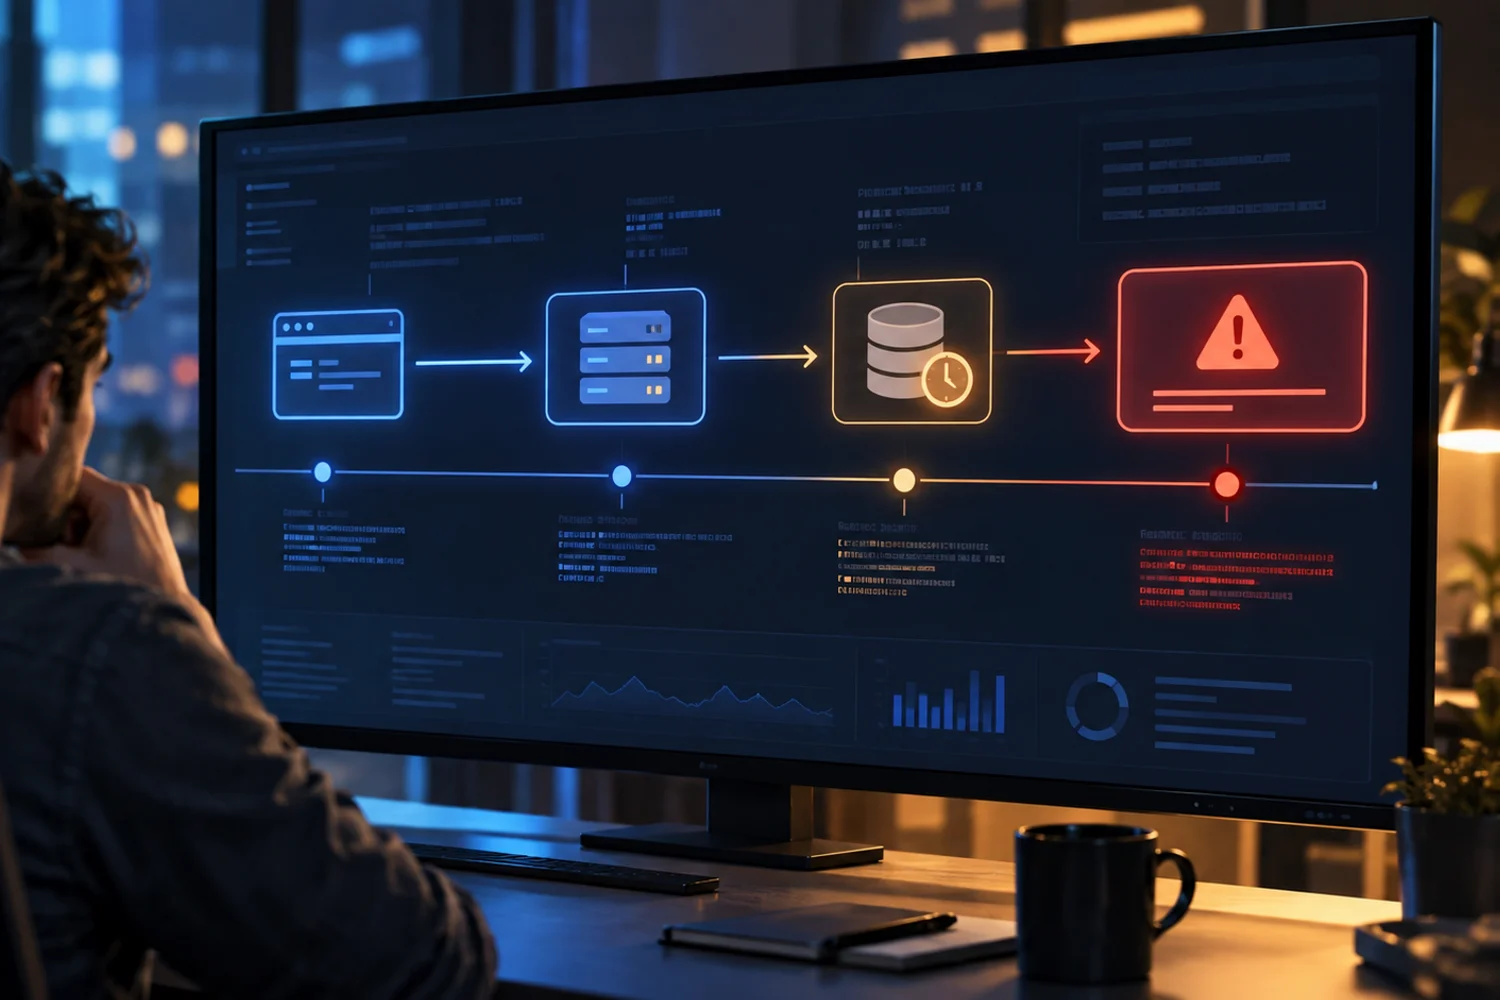
Ошибка 500 в веб-сервере может быть только последним звеном. Причина скрывается в исключении приложения, недоступной базе, истёкшем сертификате, нехватке диска или неверной конфигурации. Ищите самый ранний необычный сигнал, который появился перед цепочкой повторяющихся ошибок. Не объявляйте причиной первую красную строку без проверки.
Сравните несколько случаев. Если один и тот же request_id всегда заканчивается тайм-аутом внешнего API, гипотеза усиливается. Если ошибки распределены по одному инстансу, проверьте его ресурсы и версию. Если проблема начинается сразу после релиза, сопоставьте время деплоя и изменения конфигурации, но не делайте вывод только по совпадению.
Связь с тестированием удобно увидеть в материале о юнит-тестах для новичков: тесты проверяют ожидаемое поведение, а логи показывают, как система повела себя в реальном запуске. А статья о техническом долге помогает связать повторяющиеся предупреждения с накопленными проблемами поддержки.
Безопасный поиск и маскирование
Не вставляйте в публичный чат строку лога целиком, если в ней есть email, телефон, токен или тело запроса. Сначала замените чувствительные значения на маски и оставьте имя поля, длину и технический контекст. Права на журналы должны соответствовать роли: чтение production-логов — это доступ к данным, а не просто просмотр текста.
Проверяйте команды поиска перед запуском на большой директории. Сначала используйте режим просмотра, ограничьте дату и файл, затем сохраняйте небольшой фрагмент результата. Не удаляйте логи во время расследования и не перезапускайте сервис только ради очистки экрана: это может уничтожить важные доказательства.
Что делать после найденной причины
Сформулируйте причину одним предложением, приложите временной диапазон, затронутый сервис, пример request_id и действие, которое воспроизводит проблему. Отдельно запишите, что уже проверено и какой сигнал опроверг альтернативные версии. Такой формат экономит время следующему специалисту.
После исправления оставьте наблюдение на период, когда ошибка обычно повторялась. Сравните частоту, задержку и долю неуспешных ответов с базовым уровнем. Если ошибка исчезла только из одного лога, убедитесь, что сбор не сломан и события не перенаправлены в другой источник.
Чек-лист чтения логов
- Известны сервис, инстанс и часовой пояс.
- Определён временной интервал с запасом до и после события.
- Строки отфильтрованы по уровню и request_id.
- Симптом отделён от более ранней причины.
- Проверены внешние зависимости и ресурсы инстанса.
- Чувствительные значения замаскированы перед передачей.
- После исправления подтверждён результат метриками и логами.
Хорошее расследование не заканчивается найденной строкой error. Нужно восстановить цепочку, проверить гипотезу на нескольких случаях и сохранить безопасный вывод для команды. Чем единообразнее структура логов и идентификаторы запросов, тем быстрее система возвращается от неизвестного сбоя к конкретному исправлению.
После инцидента полезно улучшить сам журнал: добавить недостающий контекст, ограничить повторяющиеся сообщения, договориться о названиях уровней и описать срок хранения. Это снижает нагрузку на хранилище и делает следующий поиск быстрее. Логирование — часть эксплуатации продукта, поэтому его качество стоит обсуждать на планировании, а не вспоминать только во время аварии.